Harness Engineering:让 AI Agent 不再散架的系统设计
大多数人在错误的层面改进 agent——失败了改 prompt,再失败加指令,然后换模型、加工具、扩上下文。但很多失败根本不是推理失败,而是环境失败:agent 不知道哪些文件重要、丢掉了上一轮的决定、没跑检查就宣称成功、部分失败后重复了同一个动作。模型未必是问题,模型周围那套系统不完整才是——那套系统叫 harness。
本文是对原文的提炼与结构重组,非逐句翻译。原文为 agent 工程社区共识的高质量综述,不是原创研究,当框架用合适,当「新发现」看会高估。
核心论点
Prompt 只改变一次尝试,harness 改变每一次尝试。
模型能推理、生成、比较、选择,但 agent 还必须与真实环境交互:找到相关上下文、选择并使用工具、保存状态、遵守权限、检查结果、从失败中恢复,并且证明工作已完成。模型是推理引擎,harness 是让推理可执行的其余一切——强模型装在弱 harness 里仍然是弱 agent。
harness 工程的目标不是消除模型的不确定性,而是把不确定性关进一个能观察、能验证、能恢复的系统里。
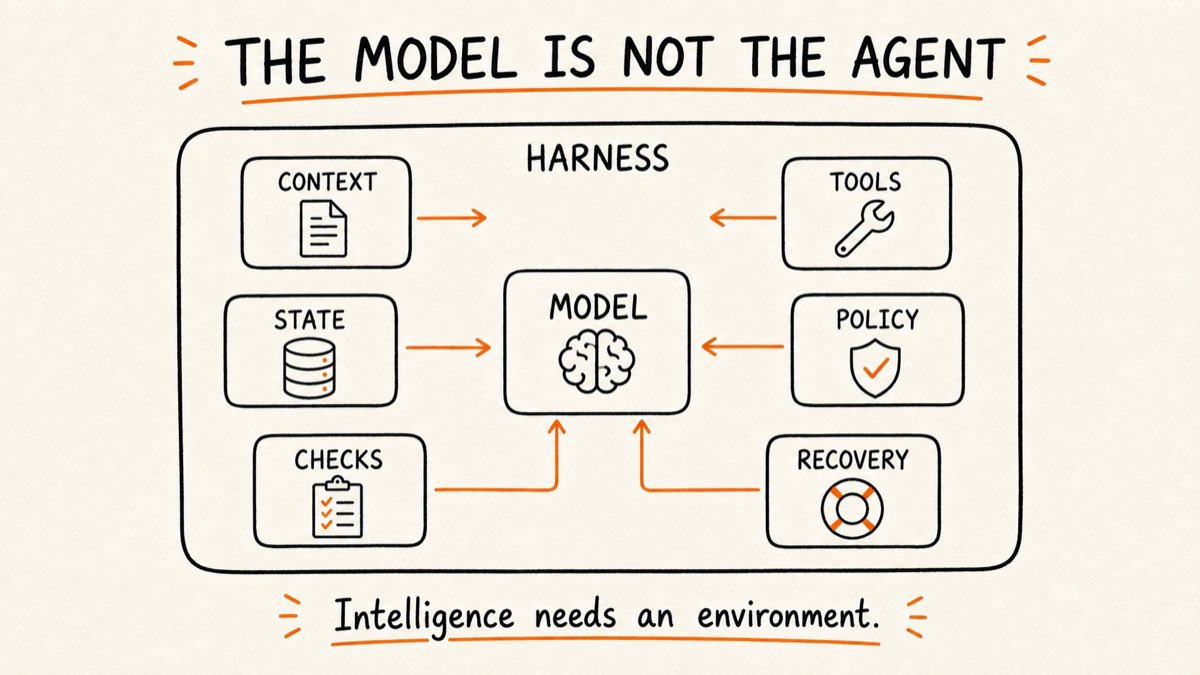
框架:原文 19 节按主题合并为五组
模型不是 agent;动手前先写任务契约
模糊意图(「改进一下 onboarding」)拿来聊天够用,拿来自主执行不够。harness 应把请求转成一份任务契约,回答五个问题:必须产出什么结果、什么在范围内、什么绝对不能改、什么证据能证明完成、哪些动作需要人工审批。
这把 agent 的问题从「我下一步该做什么」换成了「哪个动作能让环境更接近契约里的结果」。没有契约,它优化的是看起来像在干活。
给地图不给手册;要工具网关不要工具堆;分开大脑、手和历史
把整个仓库和所有历史塞进上下文不是上下文工程,是上下文洪水。正确做法是先给小地图,需要时再下钻——上下文的膨胀应该由任务驱动,不是由「信息存在」驱动。目标是每 token 的信号量最大,不是上下文最大。
给 agent 二十个工具不会让它更能干,只会给它二十种犯错方式。工具网关负责隐藏无关工具、校验参数、限制路径、加超时、让重试幂等、返回证据而不只是「成功」。模型可以提议动作,网关决定这个动作是否有效到可以执行。
脆弱的 agent 把推理、工具调用、报错、陈旧观察全混进一条越来越长的记录里。更强的系统分三块:模型要的是正确的当前状态而非全部原始事件;沙箱要的是安全执行一个有边界的动作;会话日志要的是在上下文消失后保住发生过什么。对话历史不是记忆,它只是事件流——原始历史留给审计,编译出的持久状态留给执行。
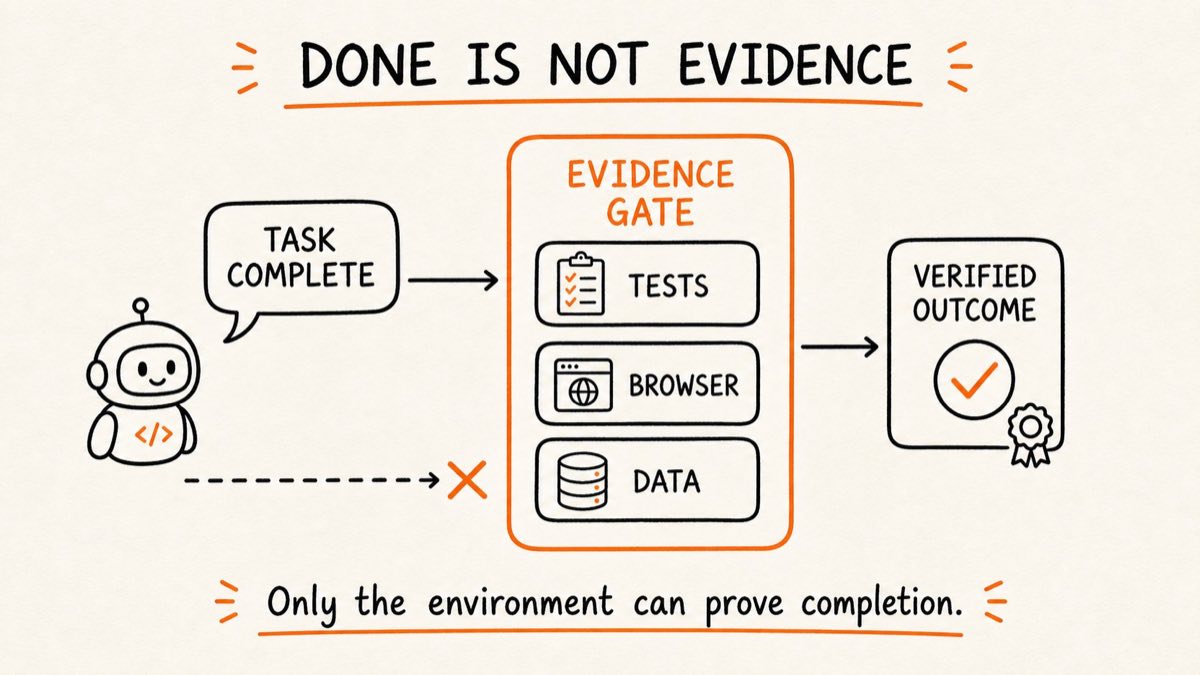
完成需要证据;验证要攻击结果;模型提议、策略授权
agent 说「done」只是又一次模型输出。完成必须由环境中可观察的变化判定,而且要先跑最便宜的确定性检查——凡是编译器、schema、校验和、查询或测试能回答的,就别再问模型。模型处理歧义,代码处理管道。
执行者和验证者不该共享目标:执行者想做出最强方案,验证者要找出应该拒绝它的理由。让同一个 agent 在同一个上下文里「再检查一遍」,它往往会保留造成错误的那些假设。验证阶段需要明确的拒绝标准、全新上下文,以及「可以只拒绝、不负责修」的权力。
有些规则不该依赖模型记不记得——它们不是提示词建议,是策略,应该放在推理循环之外,后果越严重闸门越硬。自主不是没有约束,是在清晰强制的边界内自由行动。
按失败类型恢复;指令沉淀成基础设施;观察过程;留变更回执
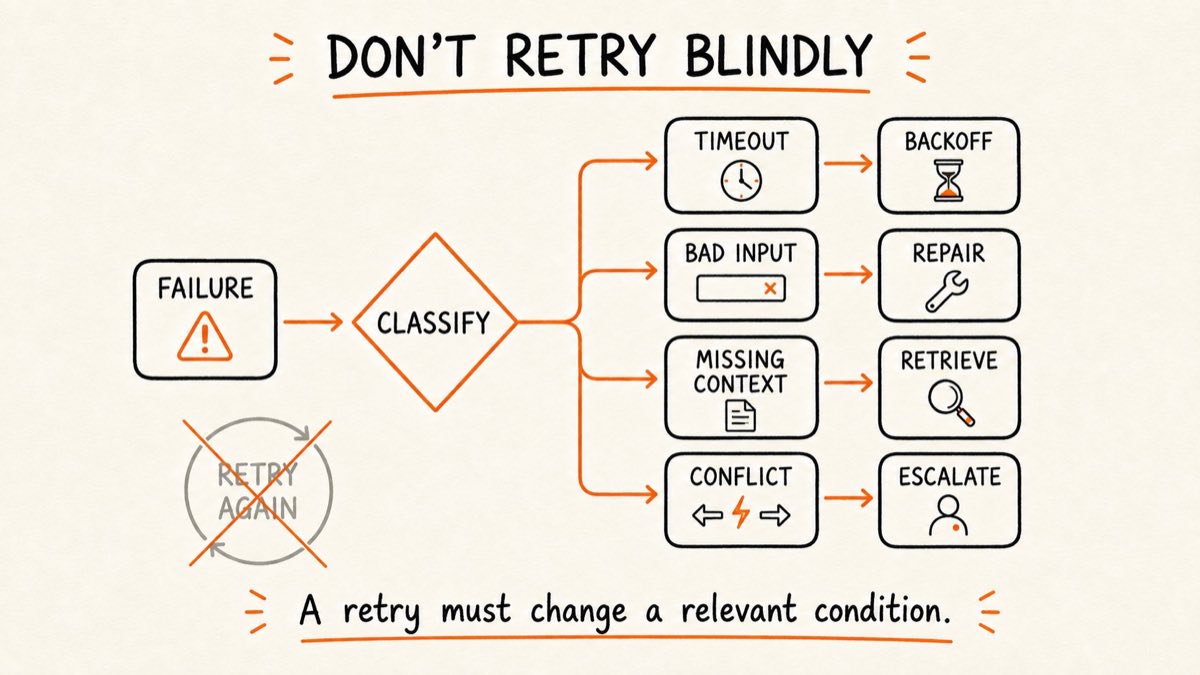
「出错了再试一次」不是恢复,是重复。要先给失败分类再选动作,一次重试至少要改变一个相关条件,否则只是在花钱复现同一个失败。每个循环都要有预算:尝试次数、时间、花费、破坏范围、升级条件。
指令解释「本地现实」时有用,但本身是很弱的强制手段——规则反复重要,就往下沉一层。prompt 负责解释判断,harness 负责强制不变量。
干净的最终产物可能掩盖糟糕的过程:读了错误的数据、忽略了失败的命令、花了十倍预算、用错误的理由得到正确答案。要的不是监控,是局部修复——第 18 步失败时能从可信检查点重启,而不是重放整个任务。运行结束再编译一张变更回执:它不是模型说了什么的摘要,而是系统能证明什么的摘要。
最弱的团队修复失败的输出,最强的团队还修复允许这个失败发生的系统。改对一个答案只帮到一次运行,改对一个 harness 帮到之后每一次。
harness 也会腐化;按层建;在正确层级度量
为昨天的模型做的绕行方案,可能挡住今天的模型用更好的策略。把 harness 组件当生产代码,定期问:它防的是哪种失败?那种失败还多久发生一次?增加了多少复杂度?去掉它会怎样?最好的 harness 不是最大的那个,而是能可靠闭合「意图」与「证据」之间差距的最小系统。Build to delete。
度量也要在正确层级:token 数不是终极指标,尝试的任务数也不是,有用的单位是「被接受的工作」。否则会掉进一个幻觉——agent 看起来极其高产,同时制造出昂贵的复核工作。
最小可用 harness:按层加,不要一次搭平台
- 有边界的任务 目标、范围、约束、验收检查
- 可读的环境 项目地图、命令、本地说明、已知依赖
- 受控的动作 类型化工具、参数校验、路径与权限边界、结构化结果
- 持久的执行 显式运行状态、检查点、决策、教训
- 证据 确定性检查、对抗式验证、变更回执
- 恢复与学习 失败分类、有界重试、升级、从重复失败反哺 harness
只建能消除你真实遇到的那个失败的最小一层。不要因为一个 prompt 偶尔需要澄清就上多 agent 架构——复杂度应该由观察到的失败来赢得。
可操作清单
- 给下一个 agent 任务写一份五问契约:结果 / 范围 / 禁改 / 完成证据 / 需审批动作
- 把「全量塞上下文」换成「先给项目地图,按需下钻」
- 给工具加参数校验、路径限制、超时和幂等重试,让它返回证据而不是
success - 把关键决策从对话历史抽出来,写进显式的运行状态文件
- 加一道确定性检查闸门,能用测试 / schema / 查询判断的就不要再问模型
- 验证换一个新上下文做,并给它「只拒绝、不修」的权力
- 重试之前先分类失败,并给循环设上尝试数 / 时间 / 花费 / 破坏范围的预算
- 每次运行结束产出一张变更回执:改了什么、证据是什么、还有什么风险没解决
- 定期问每个 harness 组件:它防的失败还存在吗?去掉会怎样?
原文配图
什么时候不需要重型 harness
直接用 prompt 就行
任务短、输出容易检查、失败代价低、没有外部副作用、人一直在环里。
该上 harness 了
工作跨多个工具或多次会话、环境会变、动作有真实后果、完成度难以人工判断、同一个失败反复出现、人工复核成为瓶颈。
我用在哪了
这一节是这个库存在的理由。没有它,收录一篇方法就只是往收藏夹里再扔一条链接。状态改成「已应用」时,这里要写清楚:用在哪个项目、具体改了什么、之后有没有少踩坑。
候选落点(站方初判,尚未验证):
- daily-pantosoph 的每日生成流水线——目前渲染完没有任何确定性检查,正好缺第 5 层的「证据闸门」:报告页生成后自动验一遍必填标记是否完整、导航日期是否最新、图片是否 404,跑不过就不算这期完成。
- novel-factory 的 agent 编排——「任务契约」和「失败分类 → 恢复策略」这两条最直接;长篇写作跨很多会话,「持久状态而非对话历史」也对得上。
- 日常用 Codex / Claude Code 的工作流——「指令阶梯」:反复要交代的规则往下沉进 AGENTS.md 或脚本,别每次靠 prompt 重说。