AI 讲书视频:一条能日更的低成本内容产线
抖音「讲书类」账号——音频旁白配静态图讲内容——已经跑通付费订阅。作者用 Codex 编排把整条产线(选题、文案、配音、分镜、生图、剪辑)AI 化,半天复刻出一期,单期成本不到十块钱,并把流程封装成了一个开源 Skill。
本案例的收入与账号数据均为原作者自述,本站未独立验证;成本与工具版本会随时间失效。不构成投资建议。
生意模型
内容形态
音频播客式旁白 + 静态配图,讲书 / 历史故事 / 故事汇 / 同人。观众主要在「听」,图片负责辅助表达和营造氛围——这决定了不该把精力堆在画面上。
变现方式
平台付费订阅为主。流量起来后开订阅,并选一个适合长期付费的赛道;原作者判断同人广播剧的订阅潜力更大。不指望纯靠平台流量分成。
产能要求
核心是效率和日更。对标账号疑似矩阵号、全 AI 产线,一天 1–2 更。原作者给自己定的目标是流程稳定后人工介入压到一小时以内。
对标与反面
形式与商业模式看「原点档案」,图片质量看「尘封档案」,文案配音学「老张说史」「枕上听书」。反面是「画案司」——做得极精致,投产比反而低。
关键数字
对标账号订阅
自述「原点档案」光抖音就有九百多个付费订阅,月订阅费约三万元。来自原作者转述,无公开凭证。
单期成本
可核10 分钟视频约需 60 张图,API 生图 0.1–0.2 元一张;手动生图几乎零成本。TTS 与 BGM 成本可忽略。
反面案例
警示「画案司」画面精致到超过很多 AI 视频,但流程太重、更新慢,作者自述三个月只挣了几百块。
工具栈
| 环节 | 工具 | 说明 |
|---|---|---|
| 编排 | Codex 或 WorkBuddy | 装入 Skill 后主动引导,逐阶段停下来确认 |
| 文案 | Kimi / Kimi-K3 | 写中文长文比 Opus 更合适(原作者实测) |
| 配音 | 豆包 Seed-TTS 2.0 | 火山引擎语音控制台申请,需拿到句级或字级时间戳 |
| 生图 | GPT Image 2 | ChatGPT 网页版手动,或第三方 API 批量 |
| 配乐 | Suno(第三方接口) | 可选项,13 分钟配乐几毛钱 |
| 剪辑 | HyperFrames | 音频 / 图片 / 字幕 / 文字卡按时间自动排轨 |
流程总览
Skill 的运行方式是:判断当前阶段 → 主动完成任务 → 只问必要问题 → 交付当前结果 → 等确认再推进。十个动作被压成五道确认关口。
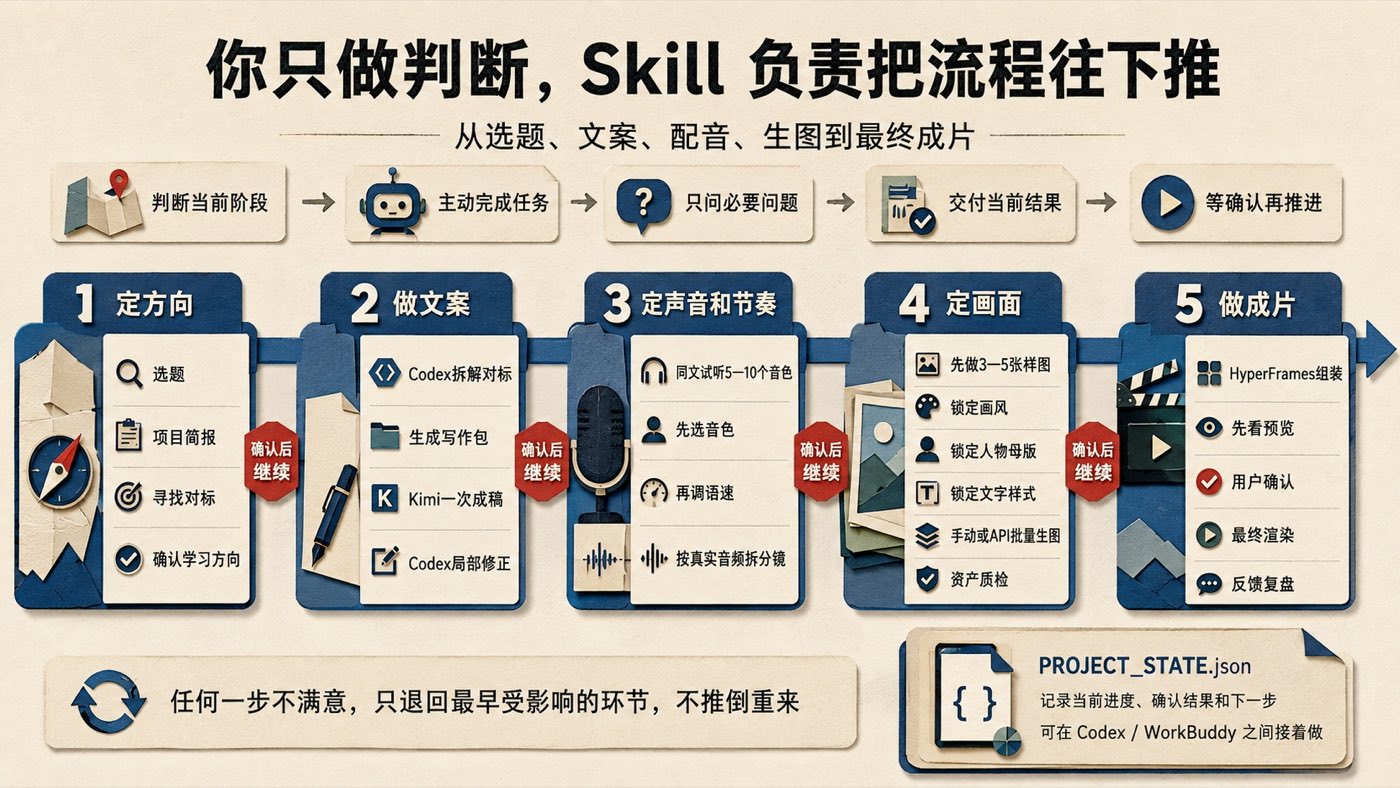
两个值得抄的机制。进度写在 PROJECT_STATE.json 里(当前进度、确认结果、下一步),因此可以在 Codex 和 WorkBuddy 之间接着做;以及「任何一步不满意,只退回最早受影响的环节,不推倒重来」——这条比工具选型重要得多。
十步工作流
- 确定选题与对标。先说清做什么类型、发哪个平台、视频多长,再定学习哪些对标账号。 关于「抄」:不是复制句子,也不是换几个词,而是学它的选题、结构、节奏、钩子、配音和制作流程。先把别人跑通的东西拆明白,再做自己的第一期。
- 文案:先学对标,再做写作包。把几篇代表对标水平的完整文案交给 Codex,让它分析选题方式、开头结构、叙事节奏、转场方法、语言特点和收尾,整理成一个「写作包」——不是一条提示词,而是包含任务、资料、对标文案、写作要求和硬规则的完整压缩包。交给 Kimi-K3(Max 模式、思考强度超高、上下文 1M)新开干净对话执行。 Kimi 的两个坑:容易重复啰嗦;第一次写不够字数时再填充,质感明显变差。字数不够不要在原稿上扩写——回 Codex 检查是材料不够、场景不够还是字数要求本身不合理,改好上游后新开对话重写。
- 文案修正。写完交回 Codex 做一轮修正:大体能用就只改有问题的地方,不整篇重写、不连续改很多轮——越改越容易把自然的句子磨得工整,AI 味反而更重。第一版完全不像样,就回头查对标是否选错、需求是否说清、写作包是否有问题;问题在哪层就回哪层改。攒够三到五篇稳定成稿后,让 Codex 提取出自己频道的文案模板。
- 配音:先选音色,再调语速。从正式文案截一小段,让 Codex 推荐 5–10 个音色各生成约 20 秒试听,所有音色必须用同一段内容才听得出差别。顺序不能反——音色不合适,调速度救不回来。 关键动作:生成完整配音时同时拿到句级或字级时间戳。后面拆分镜、换图、上字幕、加文字卡全都跟着配音时间走,不用人工逐段对齐。同一频道定下音色后不要频繁更换。
- 根据配音拆分镜。让 Codex 依据文案内容、配音时长和时间戳拆分镜:每个分镜对应哪段旁白、画面出现什么、需要几张图、有没有人物、要不要放关键信息文字。每张停留 6–8 秒时,10 分钟约需 75–100 张;第一次建议先控制在 50–60 张。 编号纪律:分镜表定下来后,生图提示词、图片文件名、旁白片段、剪辑时间全部走同一套编号,否则图一多就对不上。
- 锁画风 + 做人物母版。参考图交给 Codex 提取画风元素成固定提示词,用 GPT Image 2 出 3–5 张样图(覆盖人物近景、多人、室内、室外)。确认后画风关键词不再改。文字样式(标题、人名、时间地点、关键信息、字幕的字体颜色位置动画)同步定死。有需要长期一致的主角,先做脸部母版 + 全身母版,之后该人物出场一律走图生图。 硬性顺序:人物母版没确认前不要批量生图,否则生到后面才发现长相在变,前面的图全部重做。
- 生成每张分镜的提示词。每条与分镜编号一一对应,写清画面内容、构图、景别、人物状态、统一画风、图片比例和禁止项;有人物的写明用哪张母版。这部分全交给 Codex,人只负责拿去提交生图。
- 生图。手动路线:ChatGPT 网页版 GPT Image 2,一个对话一条提示词一张图,不要在同一对话里连塞几十张,避免一张卡住拖垮全部。自动化路线:找支持 GPT Image 2 的第三方 API 串行跑,第二天统一检查。 无论哪种:先出 3–5 张测试图,确认画风和人物没问题,再开始批量。
- 配乐(可跳过)。Suno 生成,按文案情绪排进时间轴,人声出现时自动压低。只保留配音、图片、字幕和文字卡也能成片——不要因为 BGM 没定就卡着不发。
- 剪辑与验收。把最终文案、配音、时间戳、分镜表和所有图片放进同一项目交给 Codex + HyperFrames 组装:图片跟配音走,加轻微推拉移,字幕全程显示。先看浏览器预览,不要直接渲染,重点检查开头、人物首次出现、章节切换、文字卡与字幕重叠处和结尾。 渲染完还要人看:抽帧检查 + 自己完整看一遍。机器全部通过只说明项目能跑;人物穿帮、文字错位、字幕叠字最后还是要靠人眼。
原帖配图
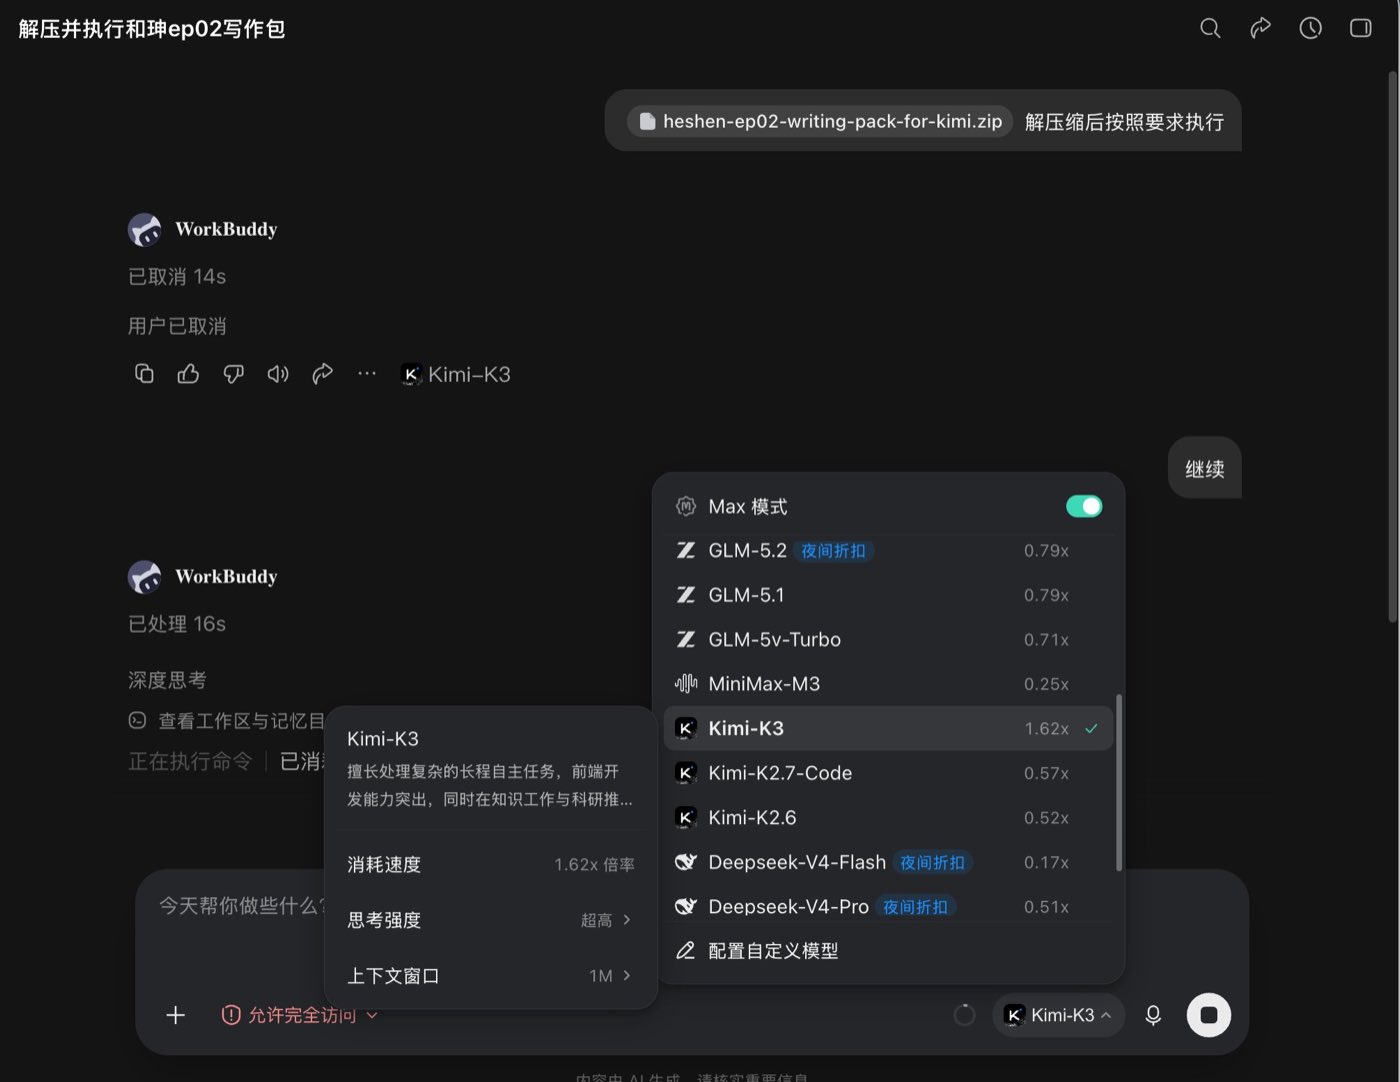
xxx-writing-pack-for-kimi.zip 丢进对话,附一句「解压缩后按照要求执行」。模型选 Kimi-K3、Max 模式开启,思考强度「超高」、上下文窗口 1M。
复刻门槛与坑
真门槛是选题和文案,不是工具。整条链路里 AI 能替掉的都是重复劳动,替不掉的是选题判断和叙事手感。前三到五期都会不稳定,这段时间没有捷径。
其次是日更能力。这个模式的收益来自频次,不是来自单期质量。做不到稳定更新,工具再顺也没有意义。
- 不要陷入精细化——观众主要在听,画面堆料的投产比很低
- 不要让文案模型围着一篇坏稿反复修,问题在哪层回哪层改
- 不要跳过测试图和人物母版直接批量生图
- 不要频繁换音色,同一频道的声音必须稳定
- 连续做 7 天到半个月流量和收益仍不好,就复盘选题文案或直接换赛道
我的判断
「半天做一期」要拆开看。那是第一期的耗时,而第一期恰恰是所有参数一次性定死的那一期(音色、画风、母版、文字样式)。第 2–5 期反而更慢,因为文案还没稳定。真正该验证的不是能不能做出一期,而是第 5 期到第 10 期的单期耗时曲线。
收入数字全部是转述。900 订阅、月费三万,这个量级在抖音付费订阅里不算离谱,但没有留存数据——月费不等于长期月费,讲书类内容的订阅衰减速度是这门生意最大的未知数。引用时必须标明是自述。
最可迁移的不是「讲书」这个题材,是编排方法。写作包(把资料、对标、规则一次打包)、时间戳驱动分镜、全流程编号一致性、PROJECT_STATE.json 断点续做——这四条换成任何「图文转视频」的题材都成立,甚至可以脱离视频用在别的产线上。题材会拥挤,方法不会。
主要风险是两个单点。一是赛道拥挤速度可能快于起号速度(这条帖子本身就在加速这件事);二是变现完全依赖单一平台的订阅政策。
与本站每日报告的关系:money 报告里的机会推演都是未验证假设,这条案例可以作为「内容型变现」这一类的基准样本——新的内容类机会出现时,拿它的成本结构和日更要求做对照。